در پست قبل دلیل شروع نوشتن این پست ها را متوجه شدیم و کمی با مفهوم نرم افزار Cloud Native یا ابرزی آشنا شدیم. در این پست کمی جلو می رویم و با اصول و قواعدی آشنا می شویم که برای داشتن یک برنامه ابرزی ضروری هستند.
فهرست مقالات
1. طراحی نرم افزار ابرزی: شروع داستان …
2. طراحی نرم افزار ابرزی: برنامه 12 عاملی
3. طراحی نرم افزار ابرزی: 12 عامل و فراتر از آن
متدولوژی The Twelve-Factor Application
یکی از متدولوژی های پذیرفته شده برای توسعه سیستم های مبتنی بر ابر متدولوژی The Twelve-Factor Application است. این متدولوژی مجموعه ای از اصول و قواعدی است که اگر در ساخت نرم افزار از آنها پیروی شود، به شما اجازه می دهد برنامه هایی داشته باشید که می توانند خیلی سریع گسترش یابند (scale)، براحتی نگهداری شوند و با اطمینان زیاد آنها را در دسترس کاربران قرار دهید.
البته این اصول را برای هر نرم افزار تحت وب دیگری هم می توان به کار برد. این متدولوژی یک زیربنا برای ساخت نرم افزارهای ابرزی است.
برای توضیح بعتر این اصول نرم افزار فرضی زیر را در نظر بگیرید
نرم افزار فرضی: یک وب سایت (وبلاگ شخصی) نوشته شده با ASP .Net Core که از یک پایگاه داده Microsoft Sql برای ذخیره سازی داده استفاده می کند. این وبلاگ برای جستجو از الستیک و برای کش هم از ردیس استفاده می کند. کل نرم افزار هم روی یک سرور مجازی راه اندازی شده است.
عامل 1. Code Base
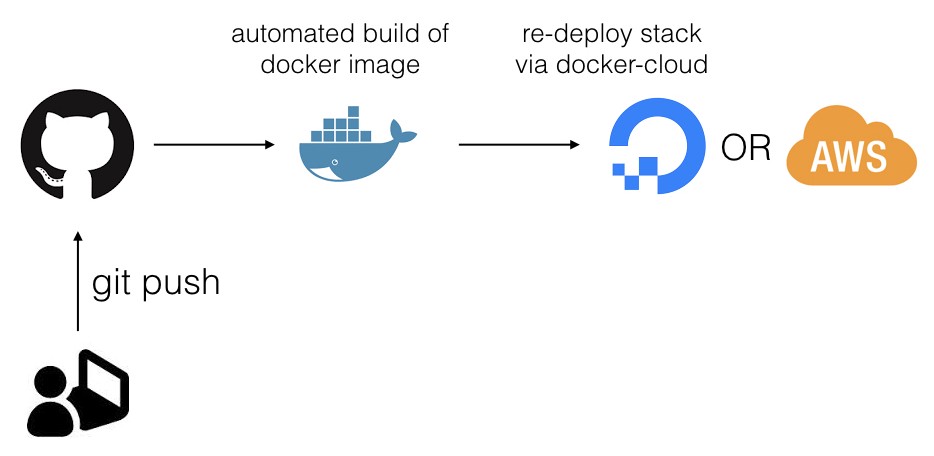
کدهای نرم افزار شما همیشه باید در یک سیستم ورژن کنترل مثل git قرار بگیرد. این نکته را در نظر داشته باشید که کل کدها باید داخل یک مخزن (repository) قرار داشته باشند. هدف این عامل این است که این قابلیت را به نرم افزار شما بدهد که بطور مستقل، با سرعت و در صورت امکان بطور خودکار در فضای ابری مستقر شود. با پیروی از این عامل می توانید با استفاده از داکر و ابزارهای دیگر، بعد از هر push نرم افزار تان را در فضای ابری مستقر کنید.
در نرم افزار فرضی به این معنی است که کل کدهای مربوط به وب سایت باید داخل یک مخزن قرار بگیرند.
عامل 2. Dependencies
برای این عامل دو تفسیر مختلف در منابع وجود دارد که مراحل مختلفی از طول عمر برنامه را هدف قرار می دهند. به نظر من هر دو تفسیر درست هستند و باید اجرا شوند.
تفسیر اول عنوان می کند که در کد مخزن شما نباید وابستگی های برنامه مثل پکیج های Node.js، فایل های Jar جاوا یا فایل های dll دات نت وجود داشته باشند. بلکه ارجاعی از این موارد در فایل وابستگی های کد شما قرار داده می شوند. تنها در زمان اجرا این نیازمندی ها باید به برنامه شما اضافه شوند.
در برنامه فرضی پوشه bin که شامل کد کامپایل شده برنامه و فایل های dll مورد نیاز هستند نباید در مخزن کد قرار بگیرند. ارجاع این کتابخانه ها هم بطور خودکار در فایل پروژه نگه داری می شوند. در زمان کامپایل این برنامه فایل این نیازمندی ها بطور واقعی دانلود می شوند و در کنار برنامه قرار می گیرند.
تفسیر دوم زمان اجرای برنامه را هدف قرار می دهد و عنوان می کند که اگر کد شما برای اجرا علاوه بر کتابخانه ها به نرم افزار خاصی نیاز دارد این مورد هم باید به همراه برنامه منتشر شود.
عامل 3. Configurations
اطلاعات مربوط به پیکربندی برنامه مثل آدرس پایگاه داده، رمز عبور پایگاه داده و … باید در خارج از برنامه شما قرار بگیرند. برای مثال می توان از متغییر های محیطی (environment variables) برای این کار استفاده کرد یا وظیفه مدیریت این نوع اطلاعات را به ابزارهای مدیریت پیکربندی سپرد.
در برنامه فرضی آدرس پایگاه داده، نام کاربری و رمز عبور پایگاه داده، آدرس دسترسی به الستیک و ردیس و نام کاربری و رمزهای عبور آنها از جمله مواردی هستند که مربوط به پیکربندی می شوند. بنابراین باید این موارد را از داخل برنامه خارج کنیم و در یکی از ابزارهای مدیریت پیکربندی قرار دهیم یا از طریق متغییرهای محیطی در اختیار برنامه قرار دهیم.
عامل 4. Backing Services
در برنامه شما منابعی جانبی مثل پایگاه داده ها، سیتسم های کش، بروکرها و … باید با استفاده از آدرس اینترنتی (URL) قابل استفاده باشند. واضح تر عنوان کنیم اینکه تمام منابع جانبی باید از طریق API قابل دسترسی باشند. دلیل این موضوع هم این است که در آینده خیلی راحت می توانید منابع موردنظر را تغییر دهید.
در برنامه فرضی یک پایگاه داده داشتیم. طبق این عامل باید به پایگاه داده از طریق یک آدرس دسترسی داشته باشیم. یعنی یک api باید طراحی کنیم و دسترسی به پایگاه داده از طریق این api صورت گیرد. مثلا چیزی شبیه https://server ip/storage/api.
برای ردیس و الستیک هم باید سرویس های جداگانه ای طراحی کنیم و دسترسی به آنها از طریق آدرس صورت گیرد. آدرس هایی مثل https://server address/cache/api و https://server address/search/api.
مزیت این راهکار چیست. به علت داشتن api و یک اینترفیس ثابت، در آینده خیلی راحت می توانید پایگاه داده، کش و سیستم جستجو را تغییر دهید بدون اینکه برنامه شما تحت تاثیر قرار بگیرد و یا نیازی به تغییر داشته باشد.
عامل 5. Build, Release, Run
شما باید محیطی را فراهم آورید که مراحل ساخت، انتشار و اجرای نرم افزار شما کاملا مجزا باشند. در عین حال برنامه شما در هر یک از این مراحل باید دارای کد منحصر به فردی نیز باشد تا بتوان در صورت بروز مشکل به نسخه های قبل بازگشت. سیستم های CI/CD مدرن چنین امکاناتی را در اختیار شما قرار می دهند. Jenkins و GitLab CI از جمله این سیستم ها هستند.
در برنامه فرضی هر نسخه را با این روش شماره گذاری می کنیم. شماره نسخه- تاریخ و زمان انتشار
مثلا v100-2021-09-04-14-31
عامل 6. Processes
این عامل مطرح می کند که برنامه شما باید stateless باشد و نباید هیچ اشتراکی با سایر برنامه ها و سرویس ها داشته باشد. در صورت نیاز به ذخیره سازی state یا دیگر داده ها باید از پایگاه داده ها استفاده شود. البته در این مورد باید عامل 4 رعایت و پیاده سازی شود.
در برنامه فرضی، برنامه ما نباید از رم و فضای ذخیره سازی مشترک با دیگر برنامه ها استفاده کند. بنابراین یا باید آنرا بر روی یک سرور مجزا اجرا کنیم که جدا از پایگاه دادها، سیستم کش و جستجو باشد یا از یک کانتینر استفاده کنیم که قابلیت ایزوله سازی برنامه را برای ما فراهم کند.
عامل 7. Port Binding
این اصل بیان کننده این موضوع است که برنامه شما باید کاملا مستقل باشد و تمام فعالیت ها و سرویس های آنها باید از طریق یک پورت قابل دسترسی باشند.
در برنامه فرضی به علت اینکه برنامه های وب دات نت کور دارای سرور داخلی Kestrel است در واقع این عامل بطور پیش فرض رعایت شده است و کل فعالیت ها و سرویس های برنامه از طریق یک پورت قابل دسترسی هستند.
اگر هم برنامه دارای چنین قابلیتی نبود نیاز بود که یک وب سرور به برنامه اصلی اضافه شود و دو قسمت به همراه یکدیگر منتشر و اجرا شوند.
عامل 8. Concurrency
مقیاس پذیری، موضوعی است که این عامل به آن اشاره دارد. در واقع برنامه شما باید به گونه ای ساخته شود که بتواند بدون مشکل به درخواست ها پاسخ دهد. اما برای این کار نباید از منابع بیشتری (سی پی یو و رم) استفاده کند بلکه باید موارد بیشتری از برنامه ایجاد شوند و به درخواست ها پاسخ دهند.
در برنامه فرضی و با تغییراتی که تا کنون ایجاد کرده ایم در صورت نیاز می توانیم تعداد بیشتری از برنامه را اجرا کنیم.
عامل 9. Disposability
برنامه شما باید به گونه ای طراحی شده باشد که بتوان در زمان نیاز نمونه های (instances) آنرا به سرعت ایجاد کرد و بعد از عادی شدن شرایط بدون زحمت و مشکل نمونه های ایجاد شده را از بین برد.
به عنوان مثال برنامه شما نباید به نوعی باشد که بخشی از یک پردازش بزرگ تر را شامل شود که در این صورت از بین بردن یک نمونه از برنامه باعث از بین رفتن بخشی از پردازش می شود و نتیجه نهایی را تحت تاثیر قرار می دهد.
چون برنامه فرضی ما تنها درخواست های کاربر را دریافت می کند و به آنها جواب می دهد این مورد هم در آن رعایت شده است.
عامل 10. Dev/Prod Parity
این مورد ساده است تا جایی که امکان دارد محیط های توسعه و محصول (production) را برابر و مشابه نگه دارید. به این منظور که محیطی که نرم افزار در آن توسعه داده می شود و محیطی که برنامه در آن اجرا می شود باید دارای پیکیر بندی های مشابه و نزدیک به هم باشند.
عامل 11. Logging
یک استریم از لاگ ها برای برنامه تان باید داشته باشید. چرا؟ چون در برنامه monolithic لاگ ها معمولا در یک فایل ذخیره می شوند اما در این متدولوژی با توجه به اینکه امکان دارد یک نمونه از برنامه در هر زمانی از بین برود بنابراین لاگ آن هم از بین خواهد رفت. به همین منظور نیاز داریم که با لاگ ها هم مشابه منابع دیگر برخورد کنیم و آنها را از برنامه اصلی جدا و در قالب یک سرویس آنها را ذخیره و پردازش کنیم.
عامل 12. Admin Processes
وظایف مدیریت را از برنامه اصلی جدا کنید. اما دقت داشته باشید که این وظایف باید در همان محیط برنامه اصلی اجرا شوند.
در برنامه فرضی در هنگام اجرای برنامه باید آیکون های شبکه های اجتماعی و برخی داده های دیگر باید در پایگاه داده بارگذاری شوند. برای این منظور باید یک برنامه دیگر ایجاد شود و این کار را انجام دهد.
منابع:
1. کتاب Cloud Native DevOps with Kubernetes-O’Reilly Media نوشته John Arundel و Justin Domingus
2. Beyond the Twelve-Factor App نوشته Kevin Hoffman
3. https://docs.microsoft.com/en-us/dotnet/architecture/cloud-native/definition.
4. https://www.bmc.com/blogs/twelve-factor-app/#
5. https://tanzu.vmware.com/content/blog/beyond-the-twelve-factor-app


